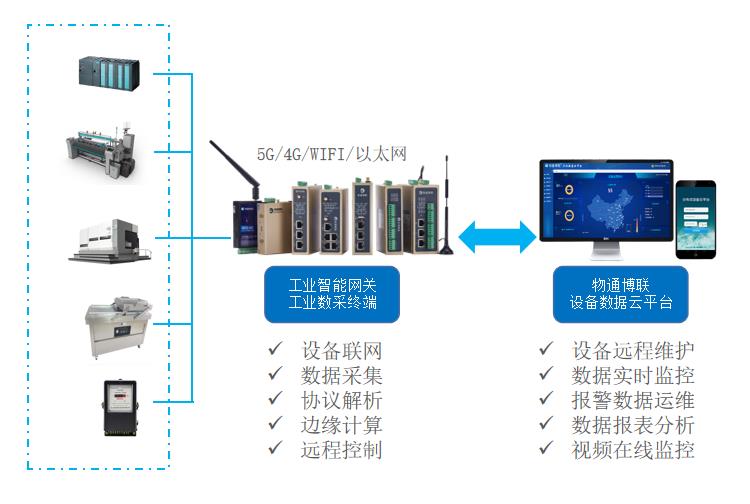
在工业互联网的讨论中,数据采集软件常被当作一个"配角"——它不像组态画面那样直观,也不像可视化大屏那样吸睛。但在实际项目中,采集层的稳定性直接决定了上层监控、分析和决策的可信度。一个点位丢失、一次时间戳错位,都可能让后续的报警管理和能耗分析失去意义。本文结合工业现场的真实约束,讨论数据采集软件在协议适配、实时性保障和边缘协同三个层面的工程要点。
协议适配:采集软件的第一道门槛
工业现场从来不是单一协议的天下。一个中等规模的制造车间,往往同时存在 Modbus RTU 的仪表、西门子 S7 系列 PLC、欧姆龙 FINS 设备,以及通过 OPC UA 暴露数据的 SCADA 子系统。数据采集软件若只支持少数几种驱动,项目落地时就得靠网关层层转接,既增加故障点,也抬高时延。
从工程实践看,成熟的采集软件通常内置数十种驱动,并支持驱动热加载。以某汽车零部件工厂的改造项目为例,现场 11 类设备、约 3200 个采集点位,若采用逐台定制开发的方式,调试周期通常在 4 至 6 周;而使用支持多协议并发的采集平台,实施周期可压缩到 10 天左右。这一差距并非来自软件本身的"智能",而是驱动库的覆盖度和配置化程度。对选型者而言,与其关注驱动数量的宣传数字,不如核实常用协议(Modbus、S7、OPC UA、MQTT)的实际连通性和异常重连机制。
实时性与数据完整性:容易被低估的指标
采集软件的核心指标不只是"能读到数",而是"读得准、读得全、读得及时"。工业场景中,1 秒级甚至 100 毫秒级的采集周期并不罕见。根据行业公开的测试数据,采用轮询方式采集 2000 个点位时,若单次轮询超时设置不当,整体扫描周期会出现明显抖动,部分点位的数据更新间隔可能拉长到设定值的 3 倍以上。
解决这一问题通常依赖两点:一是合理的采集任务分组,将高频点位与低频点位分离调度;二是断线缓存机制。现场网络中断在所难免,采集软件需要将断网期间的数据暂存于本地,恢复后按时间戳补传。某水务集团的泵站远程监控项目曾统计,边缘侧缓存能力使月度数据完整率从 92.4% 提升至 99.6%,这对后续的流量平衡分析至关重要。此外,时间戳同步也不容忽视——采集端与服务器时钟偏差若超过秒级,多源数据关联分析就会出现错位。
边缘协同:采集软件的角色正在前移
随着边缘计算网关的普及,数据采集软件的部署位置正从中心机房向现场下沉。这一变化带来两个直接好处:其一,原始数据在边缘侧完成清洗、过滤和单位换算,上行带宽压力显著降低;其二,本地闭环控制不依赖云端可用性,响应更确定。
以某电子制造企业的设备远程监控系统为例,产线侧部署边缘网关后,仅将变化数据和统计结果上传至工业物联网平台,上行数据量减少约 70%,同时报警响应时间从平均 2.3 秒缩短至 400 毫秒以内。需要注意的是,边缘侧采集并不意味着中心平台弱化——实时数据库仍需承担历史存储与跨站点聚合的职责,二者是分工而非替代关系。选型时应重点考察采集软件是否支持边缘与中心统一的组态配置,避免两套体系各自维护、版本漂移。
结语
数据采集软件的价值,最终体现在数据链路的确定性上:协议连得上、周期稳得住、断网补得回、边缘算得动。对于正在建设工业监控平台或推进设备联网的企业而言,与其在功能清单上逐项打勾,不如围绕现场的真实设备构成和网络条件做一次采集压力测试。毕竟,上层的数据可视化和报警管理系统再精致,也要建立在采集层扎实可靠的基础之上。